La próxima ventaja de la IA no estará en utilizar mejores modelos, sino en decidir qué modelo debe hacer cada tarea
La ventaja ya no estará solo en el modelo. Estará en la arquitectura que sabe elegir qué inteligencia necesita cada tarea, cuándo utilizarla y bajo qué condiciones.
Durante los últimos años hemos dedicado mucho tiempo a discutir cuál es el mejor modelo de inteligencia artificial. Esa pregunta seguirá siendo relevante, pero probablemente deje de ser la decisiva. En una empresa, la verdadera ventaja empezará a estar en saber qué inteligencia necesita cada tarea, cuándo utilizarla y bajo qué condiciones.
Durante los últimos años hemos asistido a una carrera extraordinaria. Cada nueva generación de modelos mejora en razonamiento, programación, contexto, multimodalidad, velocidad o capacidad para utilizar herramientas. Como consecuencia, buena parte de la conversación empresarial sobre inteligencia artificial ha girado alrededor de una pregunta aparentemente lógica: ¿cuál es el mejor modelo?
La pregunta tiene sentido cuando observamos la tecnología desde fuera. Si una empresa va a incorporar inteligencia artificial, parece razonable identificar la opción más potente disponible y construir alrededor de ella. El problema aparece cuando trasladamos esa lógica a la realidad de una organización, porque una empresa no tiene una sola tarea. Tiene cientos, y no todas necesitan el mismo nivel de inteligencia.
Redactar un correo comercial no plantea el mismo problema que analizar un contrato complejo. Clasificar miles de incidencias no exige lo mismo que investigar por qué está cayendo el margen de una unidad de negocio. Extraer información de una factura, revisar código, responder a clientes, interpretar documentación técnica o contrastar hipótesis estratégicas son trabajos diferentes, aunque todos puedan acabar utilizando inteligencia artificial.
Por eso creemos que la siguiente fase de adopción empresarial de IA no consistirá simplemente en disponer de modelos cada vez mejores. Consistirá en aprender a utilizar capacidades diferentes para problemas diferentes.
Y ese cambio puede ser mucho más importante de lo que parece.
El modelo más potente no siempre es la mejor decisión
Existe una tentación comprensible: si tenemos acceso al modelo más avanzado, utilizarlo para todo. De esa manera evitamos tomar decisiones intermedias y, en teoría, maximizamos la calidad de cada respuesta.
Pero capacidad no es la única variable que importa.
También existen el coste, la latencia, la frecuencia con la que se ejecuta una tarea, la sensibilidad de los datos, el tamaño del contexto, la necesidad de utilizar herramientas externas, la facilidad con la que podemos verificar el resultado y, sobre todo, las consecuencias de equivocarse.
La documentación actual de OpenAI plantea precisamente la selección de modelos como un equilibrio entre calidad, coste y latencia, y recomienda comparar configuraciones sobre tareas reales para conservar la opción más ligera que alcance el nivel de calidad necesario. No es un planteamiento exclusivo de un proveedor: Amazon Bedrock, por ejemplo, ofrece intelligent prompt routing para dirigir solicitudes entre distintos modelos en función de la calidad esperada y el coste.
La traducción empresarial es bastante sencilla. Si una organización procesa decenas de miles de operaciones repetitivas, utilizar sistemáticamente la capacidad más sofisticada disponible puede añadir coste sin mejorar de forma relevante el resultado. En cambio, cuando aparece una tarea ambigua, con información contradictoria y consecuencias importantes, ahorrar utilizando una configuración insuficiente puede ser una decisión mucho peor.
El objetivo, por tanto, no debería ser utilizar siempre la inteligencia más potente. Debería ser utilizar la inteligencia suficiente para resolver correctamente cada problema.
La ventaja no estará únicamente en tener acceso a una gran inteligencia artificial. Estará en saber cuándo hace falta utilizarla.
Antes de elegir el modelo hay que entender la tarea
Imaginemos un departamento financiero que recibe miles de documentos todos los meses. Buena parte del trabajo consiste en identificar determinados campos, comprobar si falta información, clasificar documentos o contrastar cantidades. Son tareas frecuentes, relativamente estructuradas y, en muchos casos, fáciles de verificar.
Pero ocasionalmente aparece una operación compleja que exige relacionar varios documentos, detectar contradicciones, interpretar una cláusula y explicar sus implicaciones antes de que alguien tome una decisión.
Desde el punto de vista de una aplicación tradicional, ambas cosas pueden pertenecer al mismo proceso. Desde el punto de vista de una arquitectura inteligente, son problemas distintos.
El primero puede resolverse con una configuración rápida y eficiente. El segundo puede justificar un modelo con mayor capacidad de razonamiento, más contexto, acceso a determinadas herramientas e incluso una revisión posterior antes de entregar el resultado.
Por eso el activo realmente importante empieza a ser nuestra capacidad para caracterizar correctamente la tarea. Necesitamos saber qué resultado buscamos, qué información hace falta, qué riesgo tiene una respuesta incorrecta, cuánto tiempo podemos esperar, qué datos pueden salir de nuestra infraestructura y cómo vamos a comprobar que el resultado es suficientemente bueno.
Una vez entendemos esas variables, elegir el modelo deja de ser una preferencia tecnológica y empieza a convertirse en una decisión de arquitectura.
De utilizar un modelo a construir una arquitectura de inteligencia
Durante los próximos años probablemente dejaremos de hablar tanto del “modelo corporativo” de una empresa.
Lo más razonable es que muchas organizaciones terminen trabajando simultáneamente con capacidades diferentes: modelos comerciales de alta capacidad, alternativas más ligeras, modelos especializados, opciones abiertas, despliegues privados para determinada información, herramientas externas, sistemas de recuperación de conocimiento, agentes, memoria y mecanismos específicos de verificación.
No porque disponer de muchos componentes sea necesariamente mejor. Una arquitectura innecesariamente compleja puede resultar más cara, difícil de gobernar y más frágil que una solución sencilla.
La cuestión es otra: poder elegir cuando esa elección genera valor.
Una empresa puede descubrir, por ejemplo, que una parte importante de determinadas interacciones se resuelve perfectamente con una configuración relativamente ligera, mientras que solo algunos casos necesitan capacidades mucho más avanzadas. Puede comprobar que ciertos datos nunca deberían abandonar su infraestructura o que determinadas tareas mejoran claramente cuando se acompañan de herramientas específicas.
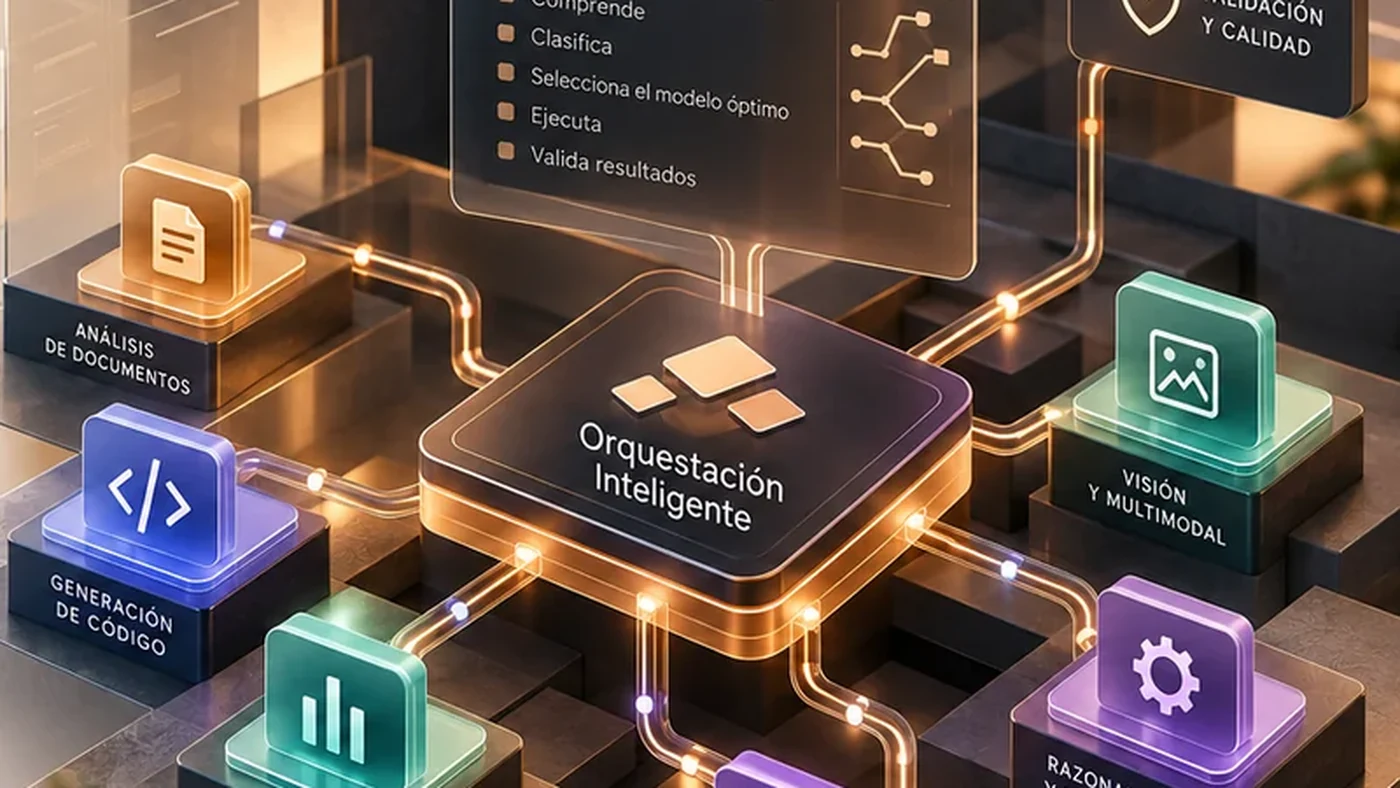
Entonces aparece una capa especialmente interesante: el sistema que decide qué hacer con cada tarea antes de ejecutarla.
Ahí entra el routing.
Un router analiza una petición y decide a qué modelo o configuración enviarla. Es una función concreta dentro del sistema. La orquestación es algo más amplio: decide no solo qué modelo interviene, sino también qué herramientas, verificadores, fuentes de datos o pasos adicionales deben participar. Y por encima de ambas está la arquitectura de inteligencia, que es el conjunto completo de decisiones, reglas, componentes y mecanismos de aprendizaje que permiten operar todo el sistema.
Conviene separar bien estos conceptos, porque no estamos hablando de tres nombres distintos para lo mismo.
Routing: una idea técnica con una consecuencia empresarial importante
La investigación sobre LLM routing parte precisamente del problema que acabamos de describir. Si enviamos todas las consultas al modelo más potente, podemos obtener mucha calidad, pero estaremos pagando esa capacidad incluso cuando no aporta una diferencia significativa. Si enviamos todo al modelo más económico, reduciremos costes, pero podemos degradar aquellas tareas donde la capacidad sí importa.
RouteLLM, desarrollado por LMSYS, plantea precisamente ese equilibrio: dirigir las consultas más sencillas hacia modelos menos costosos y reservar los más capaces para aquellas situaciones donde aportan suficiente mejora como para justificar el coste adicional.
Lo interesante no es tanto la implementación concreta como el principio que hay detrás.
Cuando una empresa empieza a realizar cientos de miles de interacciones con IA, pequeñas diferencias en coste por tarea pueden terminar acumulándose. Pero optimizar no significa simplemente abaratar. Significa reservar capacidad donde realmente cambia el resultado.
Amazon está llevando esa misma lógica a producto mediante su sistema de intelligent prompt routing, que analiza cada solicitud y selecciona dinámicamente entre modelos de una misma familia tratando de equilibrar calidad esperada y coste. Eso demuestra que el routing ya no es únicamente una línea de investigación; está empezando a incorporarse a infraestructuras comerciales de IA.
La oportunidad aparece entre los dos extremos: ni utilizar siempre el modelo más caro ni utilizar siempre el más barato. Utilizar la capacidad adecuada para cada tarea.
Pero coste y calidad no son las únicas variables
Sería un error reducir toda esta discusión a encontrar el modelo más barato capaz de completar una tarea.
Una empresa trabaja con restricciones y riesgos que muchas veces pesan bastante más que el coste de la inferencia. Una consulta puede contener información confidencial. Otra puede necesitar responder prácticamente en tiempo real. Una tercera puede intervenir en una decisión contractual, financiera o regulatoria donde equivocarse tiene consecuencias mucho mayores que cualquier ahorro conseguido utilizando un modelo más económico.
Por eso una arquitectura madura debería valorar conjuntamente calidad, coste, latencia, privacidad, fiabilidad, necesidad de razonamiento, contexto, herramientas disponibles y criticidad del resultado. No como una lista independiente de criterios, sino como dimensiones de una misma decisión.
Y algunas veces esa decisión ni siquiera consistirá en escoger un único modelo.
Puede ser preferible que un modelo genere una propuesta y otro la revise. Determinados cálculos pueden pasar por un verificador independiente. Algunas respuestas pueden contrastarse con reglas objetivas antes de aceptarse. En procesos especialmente críticos, una persona seguirá formando parte de la cadena de decisión.
Cuando empezamos a combinar estas posibilidades ya no estamos hablando simplemente de model routing.
Estamos hablando de orquestación de inteligencia.
Y ahí empieza una etapa bastante más interesante de la IA empresarial.
El verdadero salto llegará cuando el sistema aprenda de lo que ocurre
En una primera fase, la selección puede construirse mediante reglas relativamente sencillas. Las tareas rutinarias utilizan una configuración eficiente. Las que requieren razonamiento complejo escalan a capacidades superiores. La información sensible permanece en entornos controlados y determinadas familias de consultas activan herramientas específicas.
Eso ya puede generar mejoras.
Pero existe un paso siguiente.
Cada ejecución produce información. Podemos saber qué modelo respondió, cuánto tardó, cuánto costó, si utilizó herramientas, si superó las verificaciones y si posteriormente una persona corrigió el resultado.
Podemos descubrir que una tarea que considerábamos difícil se resuelve perfectamente con una configuración pequeña, mientras que otra aparentemente sencilla genera errores con frecuencia. También podemos comprobar que determinados problemas mejoran mucho cuando existe una segunda revisión y que en otros casos esa revisión solo añade coste y latencia.
Si esa información se conserva y se utiliza correctamente, la arquitectura puede empezar a aprender qué configuraciones funcionan mejor para cada familia de trabajo.
En ese momento aparece algo mucho más interesante que una simple reducción de costes: la organización comienza a acumular experiencia propia sobre cómo utilizar inteligencia artificial.
Ese conocimiento tiene valor porque no viene incluido en ninguna API.
Dos compañías pueden contratar exactamente los mismos modelos y obtener resultados muy distintos. Una puede limitarse a utilizarlos. La otra puede haber aprendido durante meses qué configuración funciona mejor para cada proceso, dónde aparecen los errores, qué tareas necesitan verificación, cuándo merece la pena escalar y qué combinación ofrece el mejor equilibrio entre calidad, coste y velocidad.
Los modelos están disponibles para ambas.
La experiencia operativa no.
Los modelos pueden terminar convirtiéndose en commodities. El conocimiento sobre cómo utilizarlos puede convertirse en propiedad intelectual.
Esto cambia también nuestra relación con los proveedores
Durante la primera etapa de la IA generativa era frecuente preguntar a una empresa tecnológica qué modelo utilizaba. La respuesta parecía decir mucho sobre la calidad del producto.
Cada vez dirá menos.
Si construimos una arquitectura suficientemente desacoplada, el modelo se convierte en un componente reemplazable. Hoy una determinada opción puede ser excelente para una tarea y mañana aparecer otra que la resuelva mejor, más rápido o a menor coste. Puede surgir una alternativa abierta suficientemente buena. Puede cambiar la política de precios o aparecer una necesidad de soberanía de datos que obligue a trasladar parte del procesamiento a infraestructura privada.
Eso no significa que todas las empresas deban trabajar con diez proveedores simultáneamente. Sería confundir flexibilidad con complejidad.
Significa diseñar los sistemas importantes de manera que el valor permanezca en la empresa aunque cambie el modelo que hay debajo.
Si aparece una opción mejor, deberíamos poder evaluarla. Si aporta valor, incorporarla. Y si no lo aporta, ignorarla sin necesidad de replantear toda la estrategia.
Precisamente por eso resulta especialmente relevante que distintos actores del mercado estén evolucionando hacia sistemas de selección o routing, en lugar de defender exclusivamente una arquitectura monomodelo. OpenAI recomienda experimentar entre modelos y niveles de razonamiento según la tarea, mientras que Amazon ofrece ya routing dinámico dentro de Bedrock. Son enfoques diferentes, pero ambos apuntan hacia una misma realidad: no existe una configuración universalmente óptima para todo.
No sabemos quién tendrá el mejor modelo dentro de tres años, y quizá no importe demasiado
La velocidad a la que está evolucionando este mercado debería hacernos prudentes a la hora de realizar apuestas permanentes.
Los modelos mejoran. Los precios cambian. Capacidades que hace poco parecían extraordinarias terminan apareciendo en configuraciones más ligeras. Nuevas arquitecturas permiten modificar el nivel de razonamiento y ajustar mejor el equilibrio entre calidad, coste y latencia.
Intentar acertar hoy quién ganará la carrera puede ser menos importante que construir una empresa capaz de beneficiarse de cualquiera que la gane.
Si mañana aparece un modelo mejor para programación, podremos incorporarlo. Si otro supera a los demás en análisis documental, podremos probarlo. Si una tarea puede resolverse de forma fiable con una opción mucho más pequeña, podremos utilizarla. Y si determinadas cargas necesitan ejecutarse en infraestructura propia, podremos plantearlo sin rehacer todo el sistema.
Esa capacidad de adaptación puede tener más valor a largo plazo que una apuesta monolítica por un proveedor determinado.
Y hay una pregunta todavía más importante: ¿necesitamos IA para esta tarea?
En medio de la actual carrera por incorporar inteligencia artificial, esta pregunta puede parecer casi provocadora.
Pero es una de las que deberíamos hacernos con mayor frecuencia.
Existen problemas perfectamente resolubles mediante reglas, software convencional, búsquedas estructuradas o algoritmos deterministas. Introducir un modelo generativo puede aumentar coste, reducir predictibilidad y añadir complejidad sin producir una mejora real.
Una arquitectura verdaderamente inteligente no debería limitarse a decidir qué modelo utilizar.
Debería ser capaz de concluir también que esa tarea no necesita ningún modelo.
Esto no es un detalle técnico. Responde a una filosofía mucho más amplia: la tecnología no debería introducirse porque podemos utilizarla, sino porque mejora de forma demostrable la manera de resolver un problema.
Y en una empresa esa disciplina termina siendo más importante que cualquier demostración espectacular.
La IA empresarial está dejando de ser un problema de modelo para convertirse en un problema de arquitectura
Durante la primera fase de la IA generativa, disponer de acceso a un buen modelo ya suponía una ventaja.
Después empezamos a conectarlo con documentos, bases de conocimiento y procesos internos.
Ahora estamos entrando progresivamente en una etapa diferente, donde el problema será cómo combinar modelos, agentes, herramientas, datos, memoria, infraestructura y mecanismos de verificación dentro de un sistema coherente.
Eso obliga a cambiar nuestra forma de pensar.
La conversación deja de girar exclusivamente alrededor del modelo y empieza a centrarse en la arquitectura. Las demostraciones importan menos que las evaluaciones. La elección de proveedor deja de ser necesariamente una decisión permanente y pasa a formar parte de un sistema capaz de cambiar componentes cuando existen razones para hacerlo.
Y, sobre todo, aparece la necesidad de medir.
Porque ninguna arquitectura podrá decidir correctamente qué inteligencia necesita una tarea si la organización no ha definido previamente qué significa resolverla bien.
Aquí está probablemente una de las dificultades menos visibles de todo este proceso.
Las empresas tendrán que construir sus propios criterios de calidad. No podrán depender únicamente de benchmarks públicos que evalúan problemas genéricos. Necesitarán utilizar sus documentos, sus operaciones, sus clientes, sus restricciones y sus casos reales para determinar qué resultados consideran aceptables.
Un modelo puede ser extraordinario en una clasificación pública y no aportar ninguna ventaja relevante en el proceso que realmente importa a nuestra empresa.
Solo la evaluación propia puede responder esa pregunta.
La próxima ventaja de la IA probablemente será invisible
El resultado más interesante de toda esta evolución puede ser que el usuario no perciba nada de ella.
El empleado seguirá utilizando un copiloto, un agente o una aplicación aparentemente sencilla. Hará una petición y recibirá un resultado.
Pero detrás pueden haberse producido decisiones muy diferentes.
Una tarea rutinaria puede utilizar una configuración rápida y económica. Otra necesitar mayor razonamiento. Una consulta sensible permanecer dentro de infraestructura privada. Determinados cálculos pasar por mecanismos de verificación y una investigación compleja utilizar varias herramientas antes de producir una respuesta.
El usuario no tendrá por qué conocer ninguna de esas decisiones.
Y probablemente sea mejor así.
No deberíamos pedir a miles de empleados que aprendan qué modelo seleccionar para cada situación. Deberíamos intentar construir sistemas capaces de tomar esa decisión de forma fiable por ellos.
Ahí puede aparecer una de las próximas ventajas competitivas de la inteligencia artificial: una capa de inteligencia sobre la propia inteligencia.
Una arquitectura que no solo sabe responder preguntas, sino que sabe decidir cómo deberían ser respondidas.
Perspectiva Tessermint
En Tessermint creemos que la siguiente etapa de la inteligencia artificial empresarial no consistirá simplemente en desplegar más modelos ni en perseguir cada nueva generación que aparezca en el mercado.
Consistirá en construir arquitecturas capaces de entender la tarea, seleccionar los recursos adecuados, orquestarlos cuando sea necesario, evaluar el resultado y aprender progresivamente de cada ejecución.
A veces la decisión será utilizar el modelo más avanzado disponible. En otras ocasiones bastará uno mucho más sencillo. Algunas tareas necesitarán varios modelos, herramientas y verificadores. Y otras no necesitarán inteligencia artificial en absoluto.
Lo importante es que esa decisión deje de ser improvisada.
Porque el acceso a modelos cada vez mejores tenderá a generalizarse.
Lo que no se generalizará con la misma facilidad será el conocimiento acumulado sobre qué inteligencia utilizar, para qué problema, bajo qué condiciones y con qué nivel de confianza.
Y probablemente ahí empiece la siguiente ventaja competitiva real de la IA empresarial.